


Türkçenin Yapay Zekâ Sınavı: Efsaneler, Gerçekler ve Bir Dili Makineye Anlatmanın Mantığı
Son yıllarda teknoloji dünyasında sıkça dile getirilen bir cümle var: “Türkçe, yapay zekâya en uygun dildir.”
Bu cümleyi duyduğumuzda, doğrusu insanın hoşuna gidiyor. Kendi dilimizin yalnızca tarihî ve kültürel değeriyle değil, geleceğin teknolojileri bakımından da ayrıcalıklı olduğunu düşünmek bir gurur vesilesi oluyor. Ancak bilim, hoşumuza giden cümlelerle yetinmez. Bir iddianın doğru olup olmadığını anlamak için onun arkasındaki yapıya bakmak gerekir.

 Nitekim yıllar önce, İstanbul Büyükşehir Belediye Başkanlığı yapmış olan Sayın Bedrettin Dalan tarafından dile getirilen “Türkçe, yapay zekâya en uygun dildir” şeklindeki değerlendirme bugün yeniden hatırlanmaktadır. Bu söz, yapay zekânın günlük hayatımızın bu kadar merkezine yerleştiği bir dönemde, geçmişten bugüne uzanan ilginç bir düşünce köprüsü kuruyor. Fakat Dalan’ın sözünü bilimsel bir hüküm olarak değil, bugün daha ayrıntılı biçimde tartışılması gereken önemli bir öngörü olarak değerlendirmek gerekir.
Çünkü Türkçenin gerçekten dikkat çekici özellikleri vardır. Eklemeli yapısı, düzenli biçimbilgisi, sözcüklerin kök ve ekler aracılığıyla sistematik biçimde türetilmesi ve cümle içinde anlam ilişkilerinin farklı yollarla kurulabilmesi, Türkçeyi doğal dil işleme araştırmaları bakımından son derece ilginç bir dil hâline getirir.
Fakat burada önemli bir ayrım vardır: Bir dilin yapısal olarak düzenli olması, onun yapay zekâ tarafından mutlaka daha kolay öğrenileceği anlamına gelmez. İşte meselenin asıl düğüm noktası da buradadır.
Türkçenin Gücü: Eklemeli Yapı
Türkçeyi diğer birçok dilden ayıran en belirgin özelliklerden biri, eklemeli bir dil olmasıdır.
Bir köke art arda ekler getirerek yeni anlam katmanları oluşturabiliriz: ev - evler- evlerimiz- evlerimizden - evlerimizdekilerden gibi
Tek bir kökten hareket ederek çoğalan bu yapı, Türkçenin anlamı kelimenin bünyesinde yoğunlaştırabilme gücünü gösterir.
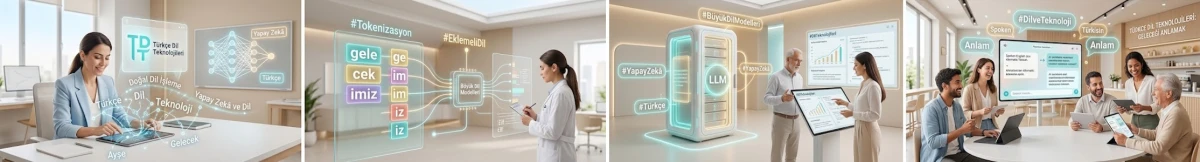
Benzer biçimde “gele-me-yecek-siniz” dediğimizde, yalnızca bir eylemi ifade etmeyiz. “Gelmek”, yeterlilik, olumsuzluk, gelecek zaman ve ikinci çoğul şahıs gibi birçok bilgiyi aynı kelimenin içerisinde taşırız.
İnsan zihni bunu çoğu zaman farkına bile varmadan gerçekleştirir. Makine açısından ise durum farklıdır.
Yapay zekâ, kelimeyi bizim algıladığımız biçimde bütünüyle bir “kelime” olarak görmek zorunda değildir. Metinler çoğu zaman token adı verilen daha küçük birimlere ayrılarak işlenir. Bu nedenle Türkçede teorik olarak üretilebilecek çok sayıdaki farklı kelime biçimi, yapay zekâ sistemleri açısından hem bir imkân hem de bir güçlük oluşturabilir. Dolayısıyla Türkçenin düzenli olması, meseleyi tek başına çözmez.
Düzenlilik Her Zaman Kolaylık Değildir
Türkçede çoğul, iyelik, hâl, zaman, kişi, olumsuzluk ve benzeri anlamlar büyük ölçüde belirli kurallar içerisinde oluşturulur.
ev-ler, kitap-lar
ev-im, kitap-ım
ev-den, okul-dan
Bu yapı ilk bakışta neredeyse matematiksel bir düzen izlenimi verir.
Bir bakıma Türkçe, makinenin karşısına şöyle bir sistem koyar: Kök + ek + ek + ek...
Bu nedenle Türkçenin biçimbilgisel yapısı, doğal dil işleme araştırmaları açısından oldukça değerlidir. Ancak burada da ince bir paradoks vardır. Düzenlilik bir taraftan makinenin kuralları keşfetmesini kolaylaştırabilirken, diğer taraftan çok sayıda farklı kelime biçiminin ortaya çıkmasına neden olur. Eğitim verisi yeterli değilse model, aynı kökten türemiş farklı biçimlerle yeterince karşılaşamayabilir. Başka bir ifadeyle Türkçenin zenginliği, yapay zekâ için aynı anda hem avantaj hem de sınavdır.
Türkçenin Görünmeyen Özel Bilgisi
Türkçenin bir başka dikkat çekici özelliği ise bazı bilgileri açıkça söylemeden cümlenin içine yerleştirebilmesidir.
Örneğin: “Geldim.”
Bu cümlede “ben” sözcüğü yoktur. Fakat fiildeki “-dim” eki, eylemi gerçekleştiren kişinin birinci tekil şahıs olduğunu bize bildirir.
İnsan bunu doğal biçimde anlar. Makine ise açıkça yazılmamış olan bilgiyi, kelimenin ve cümlenin yapısından çıkarmak zorundadır. İşte Türkçenin ilginç taraflarından biri de budur: Söylenmeyen bazı şeyler, dilbilgisinin içinde söylenmiş gibidir. Bu durum Türkçeyi yapay zekâ araştırmaları açısından önemli bir laboratuvar hâline getirir.
Kelime Sırası Değiştiğinde Ne Olur?
Türkçenin bir başka özelliği de sözdizimindeki esnekliktir. “Ayşe kitabı okudu.” dediğimizde anlam açıktır. Ancak vurgu ve bağlama göre: “Kitabı Ayşe okudu.” veya “Ayşe okudu kitabı.” gibi farklı dizilişler de kullanılabilir.
Elbette bu cümlelerin kullanım sıklıkları ve taşıdığı vurgu aynı değildir. Fakat Türkçe, kelimelerin yalnızca yan yana dizilmesinden ibaret olmayan, bağlam ve vurgu ile anlamın değişebildiği zengin bir yapı sunar. Bu da yapay zekâ açısından önemli bir sınavdır. Çünkü makinenin yalnızca “hangi kelime nerede?” sorusuna değil, “Bu kelime neden burada ve bu cümlede neyi vurguluyor?” sorusuna da cevap verebilmesi gerekir.
Asıl Mesele Dil mi, Veri mi?
Buraya kadar Türkçenin yapısal özelliklerinden söz ettik. Peki bütün bunlar Türkçeyi yapay zekânın “en uygun dili” yapmaya yeter mi? Hayır.
Çünkü yapay zekânın bir dili öğrenmesinde yalnızca o dilin grameri belirleyici değildir. Belki de bundan çok daha önemli olan bir unsur vardır: Veri.
Bir yapay zekâ sisteminin Türkçedeki başarısı; Türkçe kitapların, akademik yayınların, haberlerin, internet içeriklerinin, teknik belgelerin, soru-cevap örneklerinin ve nitelikli dijital veri kümelerinin miktarı ve kalitesiyle yakından ilişkilidir. Bu noktada İngilizcenin bugün sahip olduğu üstünlüğü de doğru anlamak gerekir.
İngilizce, yapay zekâ açısından “daha kolay” bir dil olduğu için üstün durumda değildir. Bilim, teknoloji, yazılım, akademi ve internet içeriklerinin çok büyük bölümünün İngilizce olması, İngilizcenin yapay zekâ modelleri açısından devasa bir veri havuzuna sahip olmasını sağlamıştır.
Dolayısıyla mesele yalnızca “Türkçe nasıl bir dildir?” sorusundan ibaret değildir. Bir başka soru daha vardır: “Türkçe hakkında yapay zekânın öğrenebileceği ne kadar kaliteli veri vardır?” Bu iki soru birbirine karıştırılmamalıdır.
Türkçenin Paradoksu
Türkçenin yapay zekâ karşısındaki konumu aslında oldukça ilginç bir paradoks taşır. Türkçenin güçlü taraflarının bir kısmı aynı zamanda yapay zekâ için güçlük oluşturabilir. Eklerin düzenli olması, çok sayıda farklı kelime biçiminin ortaya çıkmasına yol açabilir.
Bir kelimenin içinde çok fazla bilginin bulunması, makinenin o kelimeyi doğru parçalara ayırmasını gerektirir. Öznenin fiil ekinden anlaşılması, açıkça ifade edilmeyen bilgilerin bağlamdan çıkarılmasını zorunlu kılar.
Sözdizimindeki esneklik ise kelimelerin sırasına bakarak anlam çıkarmayı güçleştirebilir. Bu nedenle Türkçeyi “kolay dil” olarak tanımlamak yerine, zengin ve öğretici bir dil olarak görmek daha doğru olacaktır.
Yapılandırılmış Dil, Anlaşılmış Dil Demek Değildir
Belki de bütün tartışmanın en önemli cümlesi budur:Yapılandırılmış olmak ile makine tarafından kolay anlaşılmak aynı şey değildir.
Türkçe oldukça düzenli bir yapıya sahip olabilir. Fakat yapay zekânın dili anlaması yalnızca gramer kurallarını çözmesiyle gerçekleşmez.
İnsan dili; sözcük, biçim ve cümleden çok daha fazlasıdır.
- Ses vardır.
- Anlam vardır.
- Bağlam vardır.
- Kültür vardır.
- Niyet vardır.
- Dünya bilgisi vardır.
İnsan, “Yarın görüşürüz.” dediğinde yalnızca iki kelimenin anlamını kullanmaz. Söyleyen kişinin niyetini, ilişkinin niteliğini, konuşmanın geçtiği ortamı ve hatta ses tonunu da hesaba katabilir. Yapay zekânın asıl sınavı da burada başlar. Kelimeyi tanımak başka şeydir. Kelimenin taşıdığı anlamı kavramak başka şey.
O Hâlde Bedrettin Dalan’ın Sözü Nasıl Anlaşılmalı?
Yıllar önce söylenmiş “Türkçe, yapay zekâya en uygun dildir” sözüne bugün yeniden baktığımızda, onu ne bütünüyle reddetmek ne de tartışmasız bir bilimsel gerçek olarak kabul etmek gerekir.
Bu sözün güçlü tarafı, Türkçenin gerçekten de yapay zekâ ve doğal dil işleme açısından dikkat çekici özelliklere sahip olduğuna işaret etmesidir.
Türkçenin eklemeli yapısı, düzenli biçimbilgisi, yüksek bilgi yoğunluğu ve bağlam içinde gizli bilgileri taşıyabilmesi, onu yapay zekâ araştırmaları bakımından önemli bir dil hâline getiriyor. Fakat “en uygun dil” ifadesi bilimsel açıdan fazla kesin bir hükümdür.
Daha doğru ifade şu olabilir: Türkçenin eklemeli, kurallı ve yüksek bilgi yoğunluğuna sahip yapısı, onu doğal dil işleme ve yapay zekâ araştırmaları açısından son derece ilginç ve elverişli dillerden biri hâline getirmektedir. Bu ifade hem Türkçenin gücünü teslim eder hem de bilimsel ölçüyü korur.
Türkçe Bir Test Laboratuvarı Olabilir mi?
Belki de Türkçenin yapay zekâ açısından en büyük değeri, “en kolay dil” olmasında değil, yapay zekâyı zorlayan bir dil olmasındadır. “Yapabileceklerimizdenmişsiniz.” gibi bir kelimeyi ele alalım. İnsan için bu yapı, ne kadar uzun olursa olsun, dilimizin doğal örgüsü içerisinde anlamlandırılabilir. Makine için ise kökün, eklerin, kipin, kişinin, anlamın ve bağlamın aynı anda çözümlenmesi gerekir. Bu nedenle Türkçe, yapay zekânın gerçekten dili anlayıp anlamadığını sınamak bakımından son derece değerli bir alan sunabilir.
Belki de mesele “Türkçe yapay zekâya en uygun dil midir?” sorusundan biraz daha farklı sorulmalıdır. Türkçe, yapay zekânın dili gerçekten anlayıp anlamadığını sınamak için en öğretici dillerden biri olabilir mi? Asıl üzerinde durulması gereken soru belki de budur.
Sonuç ve Değerlendirme
Türkçenin yapay zekâ ile olan ilişkisini romantik söylemlerden ve yüzeysel özgüvenden arındırarak ele almak, dilimizin teknolojik geleceği açısından hayati bir zorunluluktur. "Türkçe yapay zekâya en uygun dildir" iddiası, mutlak ve kesinleşmiş bir bilimsel yargı olmaktan ziyade; Türkçenin sunduğu muazzam yapısal imkânlara işaret eden anlamlı bir öngörüdür.
Eklemeli yapısı, düzenli morfolojisi, yüksek bilgi yoğunluğu ve esnek sözdizimi ile Türkçe; doğal dil işleme ve yapay zekâ araştırmaları için son derece zengin, sınayıcı ve güçlü bir laboratuvar niteliğindedir. Ancak bir dilin yapay zekâ sistemlerindeki başarısı, yalnızca o dilin matematiksel veya biçimsel mükemmelliğiyle sınırlı değildir. Yüksek kaliteli veri, özgün tokenizasyon yöntemleri, gelişmiş model mimarileri ve alana yapılan stratejik yatırımlar; en az dilin kendi yapısı kadar belirleyici unsurlardır.
Bu doğrultuda temel hedef, Türkçeyi yapay zekanın "en üstün dili" ilan etmek değil; bu yapısal zenginliği teknolojiye aktaracak bilimsel ve teknik altyapıyı kararlılıkla inşa etmektir. Geleceğin asıl meselesi, yapay zekânın Türkçe kelimeleri işleyebilmesi değil; Türkçenin arkasındaki anlamı, kültürü, niyeti ve bağlamı kavrayabilmesidir.
Sonuç olarak Türkçenin gelecekteki değeri, yalnızca geçmişten devraldığı kültürel mirasta değil; bu mirası ve dilsel imkânları yarının teknolojilerine ne denli güçlü biçimde aktarabildiğimizde yatmaktadır. Mesele sadece yapay zekâya Türkçe öğretmek değil; dilin ve düşüncenin sınırlarını makineye gerçekten kavratabilmektir.
Saygılarımla.
Prof. Dr. Ayhan ERDEM
Gazi Üniversitesi Öğretim Üyesi
aerdem@gazeteankara.com.tr
Gazete Ankara DHP-Köşe Yazarı
“Türkiye’nin kalbi Ankara’nın sesi”



YORUM YAP